Technique8 min de lecture
Faut-il autoriser GPTBot et les robots des IA dans robots.txt ?
Article préparé par l'équipe d'agents IA d'Ottho, relu et validé par Thibault Marty.
GPTBot, ClaudeBot, Google-Extended, PerplexityBot : faut-il les autoriser dans robots.txt ? Liste à jour au 18 octobre 2026 et lignes à copier.
Oui pour les robots de recherche des IA, si vous voulez apparaître dans leurs réponses. La décision pour les robots d'entraînement est différente : elle vous appartient, sans effet garanti sur votre visibilité. Chaque éditeur nomme ses robots différemment et change parfois ses règles, donc vérifiez la documentation officielle avant d'agir.
Que fait un robot d'IA quand il visite votre site ?
Un robot (ou crawler, logiciel qui parcourt automatiquement les pages d'un site) lit le code HTML de vos pages, comme le fait Googlebot pour le moteur de recherche Google. Certains robots d'IA utilisent ensuite ce contenu pour entraîner un modèle de langage. D'autres s'en servent pour répondre en direct à une question posée par un utilisateur, ou pour indexer vos pages dans un moteur de recherche propre à leur IA.
Le fichier robots.txt, à la racine de votre site (exemple : https://votresite.fr/robots.txt), donne des instructions à ces robots. Chaque robot respectueux lit ce fichier avant de crawler et suit les règles qui le concernent, identifiées par son nom exact (le « user-agent »).
Quels sont les principaux robots des IA en octobre 2026 ?
Chaque éditeur a sa propre liste, avec des noms précis. Voici ceux que publient les documentations officielles, consultées le 18 octobre 2026.
OpenAI distingue trois robots, décrits dans sa page « Overview of OpenAI Crawlers » : GPTBot (crawle le contenu pour l'entraînement de ses modèles), OAI-SearchBot (fait apparaître des sites dans les résultats de recherche de ChatGPT) et OAI-AdsBot (vérifie la sécurité des pages publicitaires). Un quatrième, ChatGPT-User, se déclenche quand un utilisateur demande à ChatGPT de consulter une page précise : OpenAI précise que, dans ce cas, les règles de robots.txt peuvent ne pas s'appliquer, car l'action vient de l'utilisateur.
Anthropic (l'éditeur de Claude) documente trois robots dans son centre d'aide, mis à jour le 7 avril 2026 : ClaudeBot (collecte de contenu pour l'entraînement), Claude-User (consultation d'une page à la demande d'un utilisateur de Claude) et Claude-SearchBot (amélioration de la qualité de recherche dans Claude). Les trois respectent robots.txt, et Anthropic indique tenir compte de l'instruction Crawl-delay, qui ralentit le passage du robot, lorsque c'est approprié.
Google ne crawle pas avec un robot séparé pour l'IA : il utilise Google-Extended, un jeton de contrôle sans user-agent de crawl propre, documenté dans sa page sur les robots d'exploration courants, mise à jour le 15 octobre 2026. Il sert à décider si le contenu déjà crawlé par Googlebot peut servir à entraîner les futurs modèles Gemini. Google précise que ce jeton n'a aucun effet sur la présence ni sur le classement dans la recherche Google.
Perplexity documente PerplexityBot (indexation pour les résultats de recherche Perplexity, respecte robots.txt) et Perplexity-User (visite déclenchée par la question d'un utilisateur, qui ignore généralement robots.txt pour la même raison que ChatGPT-User).
Apple décrit, dans sa page d'aide publiée le 4 septembre 2026, Applebot (alimente Siri, Spotlight et Safari) et Applebot-Extended, qui ne crawle rien lui-même : il contrôle seulement si le contenu déjà collecté par Applebot peut entraîner les modèles derrière Apple Intelligence.
Meta liste, dans sa documentation pour les webmasters, cinq robots : FacebookExternalHit (aperçus de liens partagés), Meta-WebIndexer (recherche dans Meta AI), Meta-ExternalAds (publicité), Meta-ExternalAgent (entraînement de modèles et amélioration de produits) et Meta-ExternalFetcher (consultation à la demande d'un utilisateur, qui peut ignorer robots.txt).
Enfin, CCBot appartient à Common Crawl, une association qui archive une copie du web librement accessible à tous. Plusieurs éditeurs d'IA entraînent leurs modèles sur cette archive plutôt qu'avec leur propre robot : bloquer CCBot a donc un effet plus large que bloquer un seul robot nommé.
Robot d'entraînement ou robot de recherche : quelle différence ?
OpenAI, Anthropic, Apple et Meta font tous cette distinction dans leur documentation, avec des mots proches : un robot « d'entraînement » (GPTBot, ClaudeBot, Applebot-Extended, Meta-ExternalAgent) nourrit un modèle qui sera entraîné plus tard, sans lien avec une question posée aujourd'hui. Un robot « de recherche » ou « utilisateur » (OAI-SearchBot, Claude-SearchBot, Claude-User, PerplexityBot) sert à répondre à une question posée en ce moment, ou à faire apparaître votre page dans une liste de résultats.
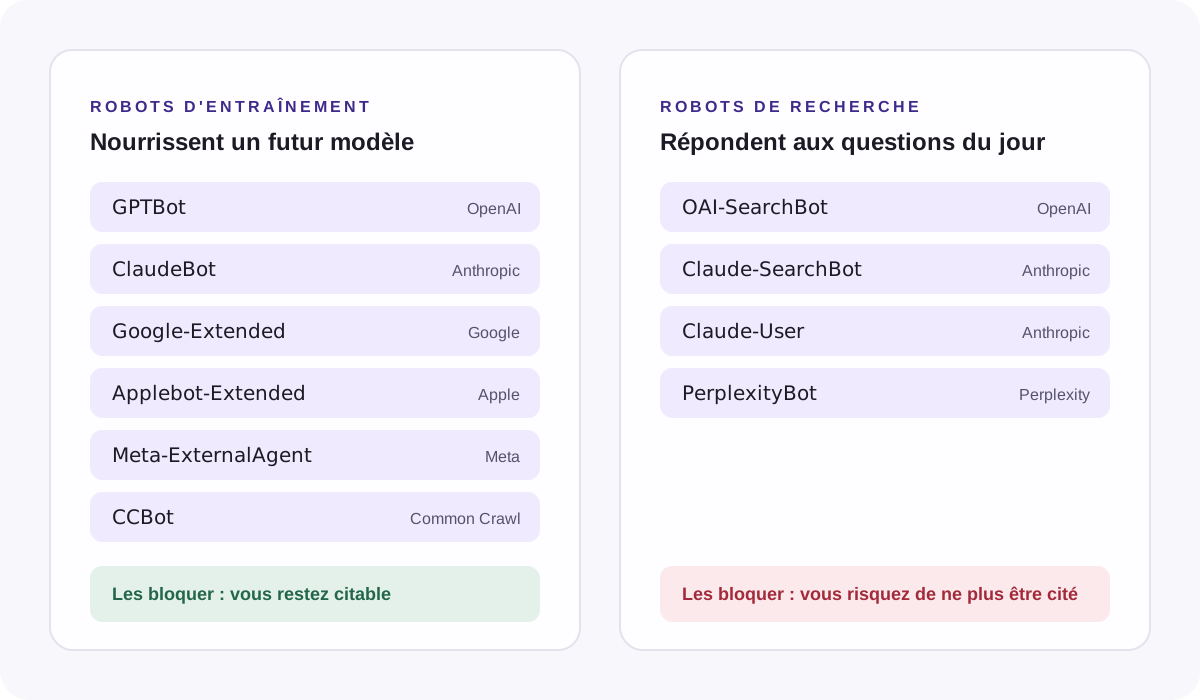
Bloquer le premier type ne retire rien à votre visibilité immédiate dans les réponses des IA. Bloquer le second peut vous empêcher d'être cité. C'est pour cette raison que la plupart des éditeurs ont séparé les deux : vous pouvez interdire l'entraînement sans sortir des résultats de recherche de l'IA.
Comment lire son fichier robots.txt ?
Ouvrez https://votresite.fr/robots.txt dans un navigateur. Vous y trouverez des blocs qui commencent par User-agent:, suivi du nom exact d'un robot (ou de * pour tous les robots non listés ailleurs), puis des lignes Disallow: (interdiction) ou Allow: (autorisation), avec un chemin. Disallow: / interdit tout le site à ce robot. Un robot qui n'a pas de bloc à son nom suit les règles du bloc User-agent: * : si ce bloc interdit tout, il est bloqué lui aussi. Certains hébergeurs ou générateurs de sites ajoutent de tels blocages par défaut, parfois sans prévenir le propriétaire du site. C'est l'une des causes d'invisibilité dans les IA que l'outil d'audit SEO et GEO par Ottho vérifie automatiquement.
Faut-il autoriser GPTBot et les autres dans robots.txt ?
Il n'y a pas de réponse unique, et aucun éditeur ne garantit une citation en échange d'un accès. Trois positions raisonnables, selon vos priorités :
- Vous voulez être cité par les IA et peu vous importe l'entraînement : autorisez tout. C'est le choix le plus simple, et celui qui maximise vos chances d'apparaître dans une réponse de ChatGPT, Claude ou Perplexity.
- Vous voulez être cité, mais pas servir à l'entraînement sans contrepartie : autorisez les robots de recherche (
OAI-SearchBot,Claude-SearchBot,PerplexityBot) et bloquez les robots d'entraînement (GPTBot,ClaudeBot,Google-Extended,Applebot-Extended,Meta-ExternalAgent,CCBot). C'est le compromis le plus courant chez les sites qui publient du contenu original. - Vous ne voulez aucun robot d'IA sur votre site, quel qu'il soit : bloquez-les tous. Vous perdez alors toute chance d'être cité par une IA qui respecte robots.txt, sans empêcher pour autant les visites déclenchées par un utilisateur qui peuvent l'ignorer (
ChatGPT-User,Perplexity-User,Meta-ExternalFetcher), puisque ces visites ne sont pas, par nature, du crawling automatique.
Quelles lignes ajouter dans robots.txt ?
Pour le compromis le plus courant (autoriser la recherche, bloquer l'entraînement) :
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: ClaudeBot
Disallow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: CCBot
Disallow: /
Pour tout autoriser, une seule ligne suffit si votre fichier ne contient pas déjà un blocage général :
User-agent: *
Allow: /
Pour bloquer tous les robots d'IA qui respectent robots.txt :
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /

User-agent: Claude-User
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: Meta-WebIndexer
Disallow: /

User-agent: CCBot
Disallow: /
Ajoutez ces lignes à la fin de votre fichier robots.txt existant, sans toucher aux blocs déjà présents pour Googlebot ou Bingbot. Un bloc par robot, avec son nom exact : une faute de frappe dans le nom (minuscule, tiret oublié) rend la ligne inefficace.
Et pour un site fait avec Claude, avant la mise en ligne ?
Si vous venez de construire un site, vérifiez trois choses avant de le publier : que robots.txt existe à la racine, qu'il n'interdit pas * par erreur (un réglage par défaut de certains générateurs de site, pensé pour un site en construction), et que les robots que vous voulez autoriser y figurent bien avec leur nom exact. Une ligne Disallow: / sous User-agent: *, oubliée après la mise en ligne, bloque Googlebot autant que les robots des IA.
FAQ
Bloquer GPTBot m'empêche-t-il d'apparaître dans ChatGPT ?
Non, pas directement. GPTBot sert à l'entraînement des modèles, pas aux réponses en direct. Pour apparaître dans une réponse de ChatGPT qui cite une source, c'est OAI-SearchBot qui compte, selon la documentation d'OpenAI.
Robots.txt bloque-t-il vraiment ces robots ? Il donne une instruction que les robots sérieux respectent, mais rien n'empêche techniquement un robot mal intentionné de l'ignorer. Pour un contrôle plus strict, il faut bloquer par adresse IP au niveau du serveur : OpenAI, Anthropic et Common Crawl publient leurs plages d'adresses à cet effet.
Google-Extended a-t-il un effet sur mon classement dans Google ? Non. Google précise explicitement que ce jeton n'affecte ni la présence dans la recherche Google ni le classement.
Dois-je revenir souvent sur ce fichier ? Oui, les noms et les règles changent : la page d'Anthropic a été mise à jour en avril 2026, celle de Google le 15 octobre 2026. Une vérification tous les deux ou trois mois suffit pour la plupart des sites.
Comment savoir si un robot qui visite mon site est le vrai GPTBot et pas un imposteur ? En comparant son adresse IP aux plages publiées par l'éditeur (un fichier JSON pour OpenAI ou Anthropic, une recherche DNS inversée pour Common Crawl). C'est une vérification technique, à faire au niveau des journaux du serveur.
Sources
- OpenAI, « Overview of OpenAI Crawlers », https://developers.openai.com/api/docs/bots, consulté le 18 octobre 2026.
- Anthropic (Claude), centre d'aide, https://support.claude.com/en/articles/8896518, consulté le 18 octobre 2026, page mise à jour le 7 avril 2026.
- Google, « Google's common crawlers », https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers, consulté le 18 octobre 2026, page mise à jour le 15 octobre 2026.
- Perplexity, « Bots », https://docs.perplexity.ai/guides/bots, consulté le 18 octobre 2026.
- Common Crawl, « CCBot », https://commoncrawl.org/ccbot, consulté le 18 octobre 2026.
- Apple, « About Applebot », https://support.apple.com/en-us/119829, consulté le 18 octobre 2026, page publiée le 4 septembre 2026.
- Meta, « Meta web crawlers », https://developers.facebook.com/docs/sharing/webmasters/web-crawlers, consulté le 18 octobre 2026.