GEO9 min de lecture
Pourquoi mon site n'apparaît pas dans les réponses des IA ?
Article préparé par l'équipe d'agents IA d'Ottho, relu et validé par Thibault Marty.
Cinq causes fréquentes expliquent l'absence d'un site dans ChatGPT et les autres IA, avec la méthode pour vérifier chacune soi-même.
Un site reste invisible dans les réponses de ChatGPT, Claude, Perplexity ou le mode IA de Google pour une combinaison de raisons précises, pas par malchance. Les cinq plus fréquentes : des robots d'IA bloqués sans le savoir dans le fichier robots.txt, un contenu qui n'existe que dans une version chargée par JavaScript, des pages sans réponse directe ni FAQ à citer, des données structurées absentes ou fausses, ou trop peu de signaux de confiance.
Chacune de ces causes se vérifie soi-même en quelques minutes, sans compétence technique poussée. Voici comment, cause par cause.
Les robots des IA sont-ils bloqués sur votre site ?
Chaque éditeur d'IA envoie un robot (un programme qui explore automatiquement les pages web) pour lire le contenu des sites. OpenAI utilise par exemple quatre robots différents selon l'usage : GPTBot pour entraîner ses modèles, OAI-SearchBot pour les résultats affichés dans la recherche de ChatGPT, OAI-AdsBot pour vérifier la sécurité des annonces, et ChatGPT-User pour les actions qu'un utilisateur demande en direct. Désactiver GPTBot dans le fichier robots.txt indique, selon OpenAI, que le contenu du site ne doit pas servir à l'entraînement de ses modèles. OAI-SearchBot se règle lui aussi dans ce fichier : un site qui l'exclut n'apparaît pas dans les réponses de recherche de ChatGPT. ChatGPT-User, parce qu'il agit sur une demande explicite d'un utilisateur, peut dans certains cas ne pas s'y arrêter.
Un fichier robots.txt mal configuré, souvent écrit par un prestataire avant l'arrivée de ces robots, peut en bloquer un ou plusieurs sans que personne s'en aperçoive. Google rappelle d'ailleurs que ce fichier sert surtout à gérer le trafic d'exploration, pas à cacher une page : un robot qui en respecte les règles et qui en est exclu ne lira simplement jamais le contenu concerné.
Comment le vérifier soi-même : tapez l'adresse de votre site suivie de « /robots.txt » dans votre navigateur (par exemple, votre-site.fr/robots.txt). Cherchez des lignes commençant par « User-agent : » suivies du nom d'un robot d'IA. Le nom exact varie selon l'éditeur (OpenAI utilise GPTBot, OAI-SearchBot, OAI-AdsBot et ChatGPT-User, comme vu plus haut). Regardez si la ligne suivante dit « Disallow: / » (bloqué) ou « Allow: / » (autorisé). À titre d'exemple, le fichier robots.txt d'ottho.co autorise explicitement l'accès à des robots de plusieurs éditeurs d'IA, dont Anthropic, OpenAI, Google et Perplexity, chacun avec sa propre ligne « Allow: / ».
Votre contenu est-il visible sans JavaScript ?
Certains sites, notamment ceux construits avec des outils modernes comme React ou Vue, affichent au départ une page presque vide, puis remplissent le contenu avec du JavaScript une fois la page chargée dans le navigateur. Google appelle cela le modèle « app shell » et prévient que si le contenu n'apparaît pas dans le HTML après exécution du JavaScript, il ne peut pas l'indexer. Google recommande d'ailleurs le rendu côté serveur ou le pré-rendu, en rappelant que « tous les robots ne peuvent pas exécuter de JavaScript ».
Un robot d'IA qui ne lit que le code envoyé directement par le serveur, sans exécuter de JavaScript, ne trouve donc rien à citer sur une page construite ainsi. Le site existe, mais pour ce robot, son contenu n'existe pas.
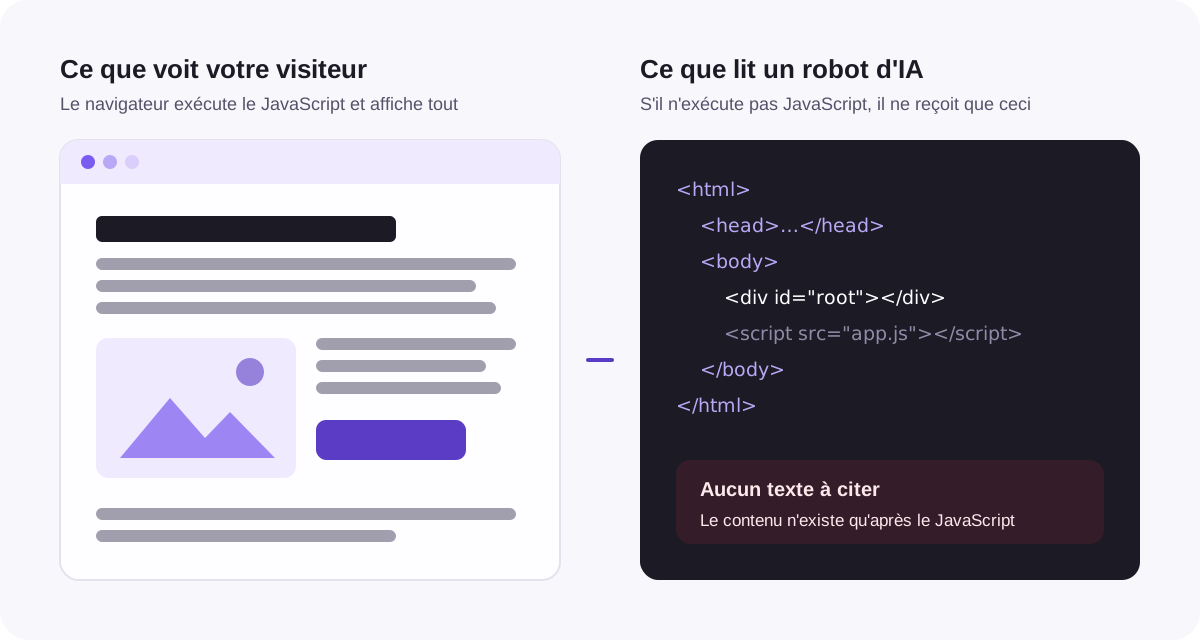
Comment le vérifier soi-même : sur une page importante de votre site, faites un clic droit puis « Afficher le code source de la page » (pas l'inspecteur, qui montre la page après son chargement complet). Cherchez, avec la fonction de recherche du navigateur (Ctrl+F ou Cmd+F), une phrase que vous voyez normalement affichée à l'écran sur cette page. Si vous ne la trouvez pas dans le code source, ce texte n'existe que grâce au JavaScript, et une partie des robots ne le verra jamais.
Vos pages répondent-elles directement à une question, avec une FAQ ?
Une IA générative (qui rédige une réponse originale à chaque question, à la différence d'un moteur de recherche qui affiche une liste de liens) a besoin d'un passage de texte qu'elle peut reprendre presque tel quel pour construire sa réponse. Une page qui noie sa réponse dans plusieurs paragraphes d'introduction, sans jamais la formuler clairement, donne moins de prise à ces outils qu'une page qui répond en deux ou trois phrases dès le début, puis détaille.
Une FAQ en fin de page joue le même rôle. Elle découpe le sujet en questions précises, proches de ce qu'un client tape réellement dans un moteur de recherche ou demande à une IA, avec une réponse courte juste en dessous. C'est une structure facile à citer.
Comment le vérifier soi-même : ouvrez vos trois ou quatre pages les plus importantes (accueil, pages de service). Pour chacune, demandez-vous : « si j'étais une IA, quelle phrase de cette page pourrais-je recopier pour répondre à la question d'un client ? » Si aucune phrase ne répond clairement à une question précise en moins de trois phrases, ou si la page n'a pas de section de questions fréquentes, c'est une piste de correction concrète.
Vos données structurées sont-elles présentes et correctes ?
Les données structurées sont des balises ajoutées dans le code d'une page pour décrire son contenu dans un langage que les machines comprennent sans ambiguïté : un produit, un article, une entreprise locale, une question-réponse, et ainsi de suite. Google explique qu'il utilise les données structurées trouvées sur le web pour comprendre le contenu d'une page, et que les ajouter revient à donner des indices explicites sur le sens de cette page.
Des données manquantes privent les robots de ces indices. Des données structurées fausses, c'est à dire qui décrivent autre chose que ce que la page montre réellement aux visiteurs, sont pires qu'une absence : elles peuvent envoyer un signal trompeur.
Comment le vérifier soi-même : sur une page clé, affichez le code source (clic droit, « Afficher le code source de la page ») et cherchez le texte « application/ld+json » avec la fonction de recherche du navigateur. Si vous ne trouvez rien, aucune donnée structurée n'est présente. Si vous en trouvez, comparez ce qui y est écrit (nom, description, prix, horaires) à ce qui est réellement affiché sur la page : toute différence est une donnée fausse à corriger.
Votre site envoie-t-il des signaux de confiance ?
Google regroupe ces signaux sous le terme E-E-A-T (l'expérience, l'expertise, l'autorité et la fiabilité d'un contenu). Parmi ces quatre aspects, Google indique que la fiabilité est le plus important : les autres y contribuent, mais un contenu n'a pas besoin de les démontrer tous pour être jugé fiable. Google accorde encore plus de poids à ces signaux pour les sujets qui peuvent avoir un impact important sur la santé, la situation financière ou la sécurité d'une personne.
Un site qui ne précise jamais qui écrit, ne cite aucune source, n'indique pas d'adresse ni de moyen de contact vérifiable, envoie peu de ces signaux, même si son contenu est par ailleurs juste.
Comment le vérifier soi-même : sur vos pages principales, cherchez un nom d'auteur réel, une page « à propos » avec une activité vérifiable, des liens vers des sources externes quand vous citez un fait ou un chiffre, et des informations de contact visibles (adresse, numéro, mentions légales). L'absence d'un seul de ces éléments n'est pas forcément grave isolément, mais leur absence combinée est un signal faible, que prestataires et outils d'audit repèrent facilement.
Ce qu'il reste à faire
Ces cinq causes se recoupent souvent sur un même site : un prestataire qui a construit un site rapide avec beaucoup de JavaScript a aussi pu, sans le vouloir, oublier les données structurées. Notre outil d'audit SEO et GEO par Ottho vérifie chacun de ces points automatiquement, avec une preuve pour chaque constat, et pose de vraies questions de clients potentiels à six IA pour voir si votre site y est cité.
FAQ
Si mon site est bien classé dans Google, pourquoi serait-il absent des réponses des IA ? Le référencement dans Google (SEO) et la citation dans les réponses des IA (GEO, pour generative engine optimization) se recoupent, mais ne sont pas identiques. Un site bien classé dans les résultats de recherche peut être absent des réponses d'une IA, par exemple si son contenu n'est pas écrit de façon à être cité directement, ou si un robot d'IA précis est bloqué alors que Googlebot ne l'est pas.
Faut-il bloquer les robots des IA pour protéger mon contenu ? Cela dépend de votre objectif, et personne ne peut garantir le résultat d'un choix ou de l'autre. Bloquer un robot comme GPTBot empêche, selon OpenAI, que votre contenu serve à l'entraînement de ses modèles. Mais un robot bloqué ne peut pas non plus lire votre contenu pour le citer dans une réponse. C'est un choix à faire en connaissance de cause, pas un réglage à copier sans réflexion.
Mon site utilise beaucoup de JavaScript, dois-je tout reconstruire ? Pas nécessairement. Il est souvent possible de faire générer par le serveur une version HTML complète des pages les plus importantes (accueil, pages de service), sans changer le reste du site. C'est un travail technique à confier à votre prestataire, pas une refonte complète.
Les données structurées garantissent-elles d'être cité par une IA ? Non. Elles aident les robots à comprendre votre contenu, mais aucun éditeur d'IA ne garantit qu'un site correctement balisé sera cité. C'est un facteur parmi plusieurs, pas une certitude.
Après avoir corrigé ces points, en combien de temps verrai-je un changement ? Il n'existe pas de délai garanti. Les réponses des IA varient d'un jour à l'autre et d'un modèle à l'autre. Mieux vaut corriger, puis retester à intervalles réguliers, par exemple chaque mois, pour voir si la tendance évolue.
Sources
- OpenAI, documentation « Bots », developers.openai.com/api/docs/bots, consultée le 18 octobre 2026.
- Google, Search Central, « Introduction to robots.txt », developers.google.com/search/docs/crawling-indexing/robots/intro, consultée le 18 octobre 2026.
- Google, Search Central, « JavaScript SEO basics », developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics, consultée le 18 octobre 2026.
- Google, Search Central, « Introduction to structured data markup », developers.google.com/search/docs/appearance/structured-data/intro-structured-data, consultée le 18 octobre 2026.
- Google, Search Central, « Creating helpful, reliable, people-first content » (E-E-A-T), developers.google.com/search/docs/fundamentals/creating-helpful-content, consultée le 18 octobre 2026.
- ottho.co, fichier robots.txt, ottho.co/robots.txt, consultée le 18 octobre 2026.